别再给AI塞小抄了。现在流行让AI自己改作业——不是靠查资料、翻文档、拼凑上下文,而是边干边学,边错边改,把经验直接刻进参数里。上海交大蔡登教授说得挺直白:'把知识存数据库里再临时翻出来,就像考试前狂背小抄,考完就忘。真本事得长在脑子里。'
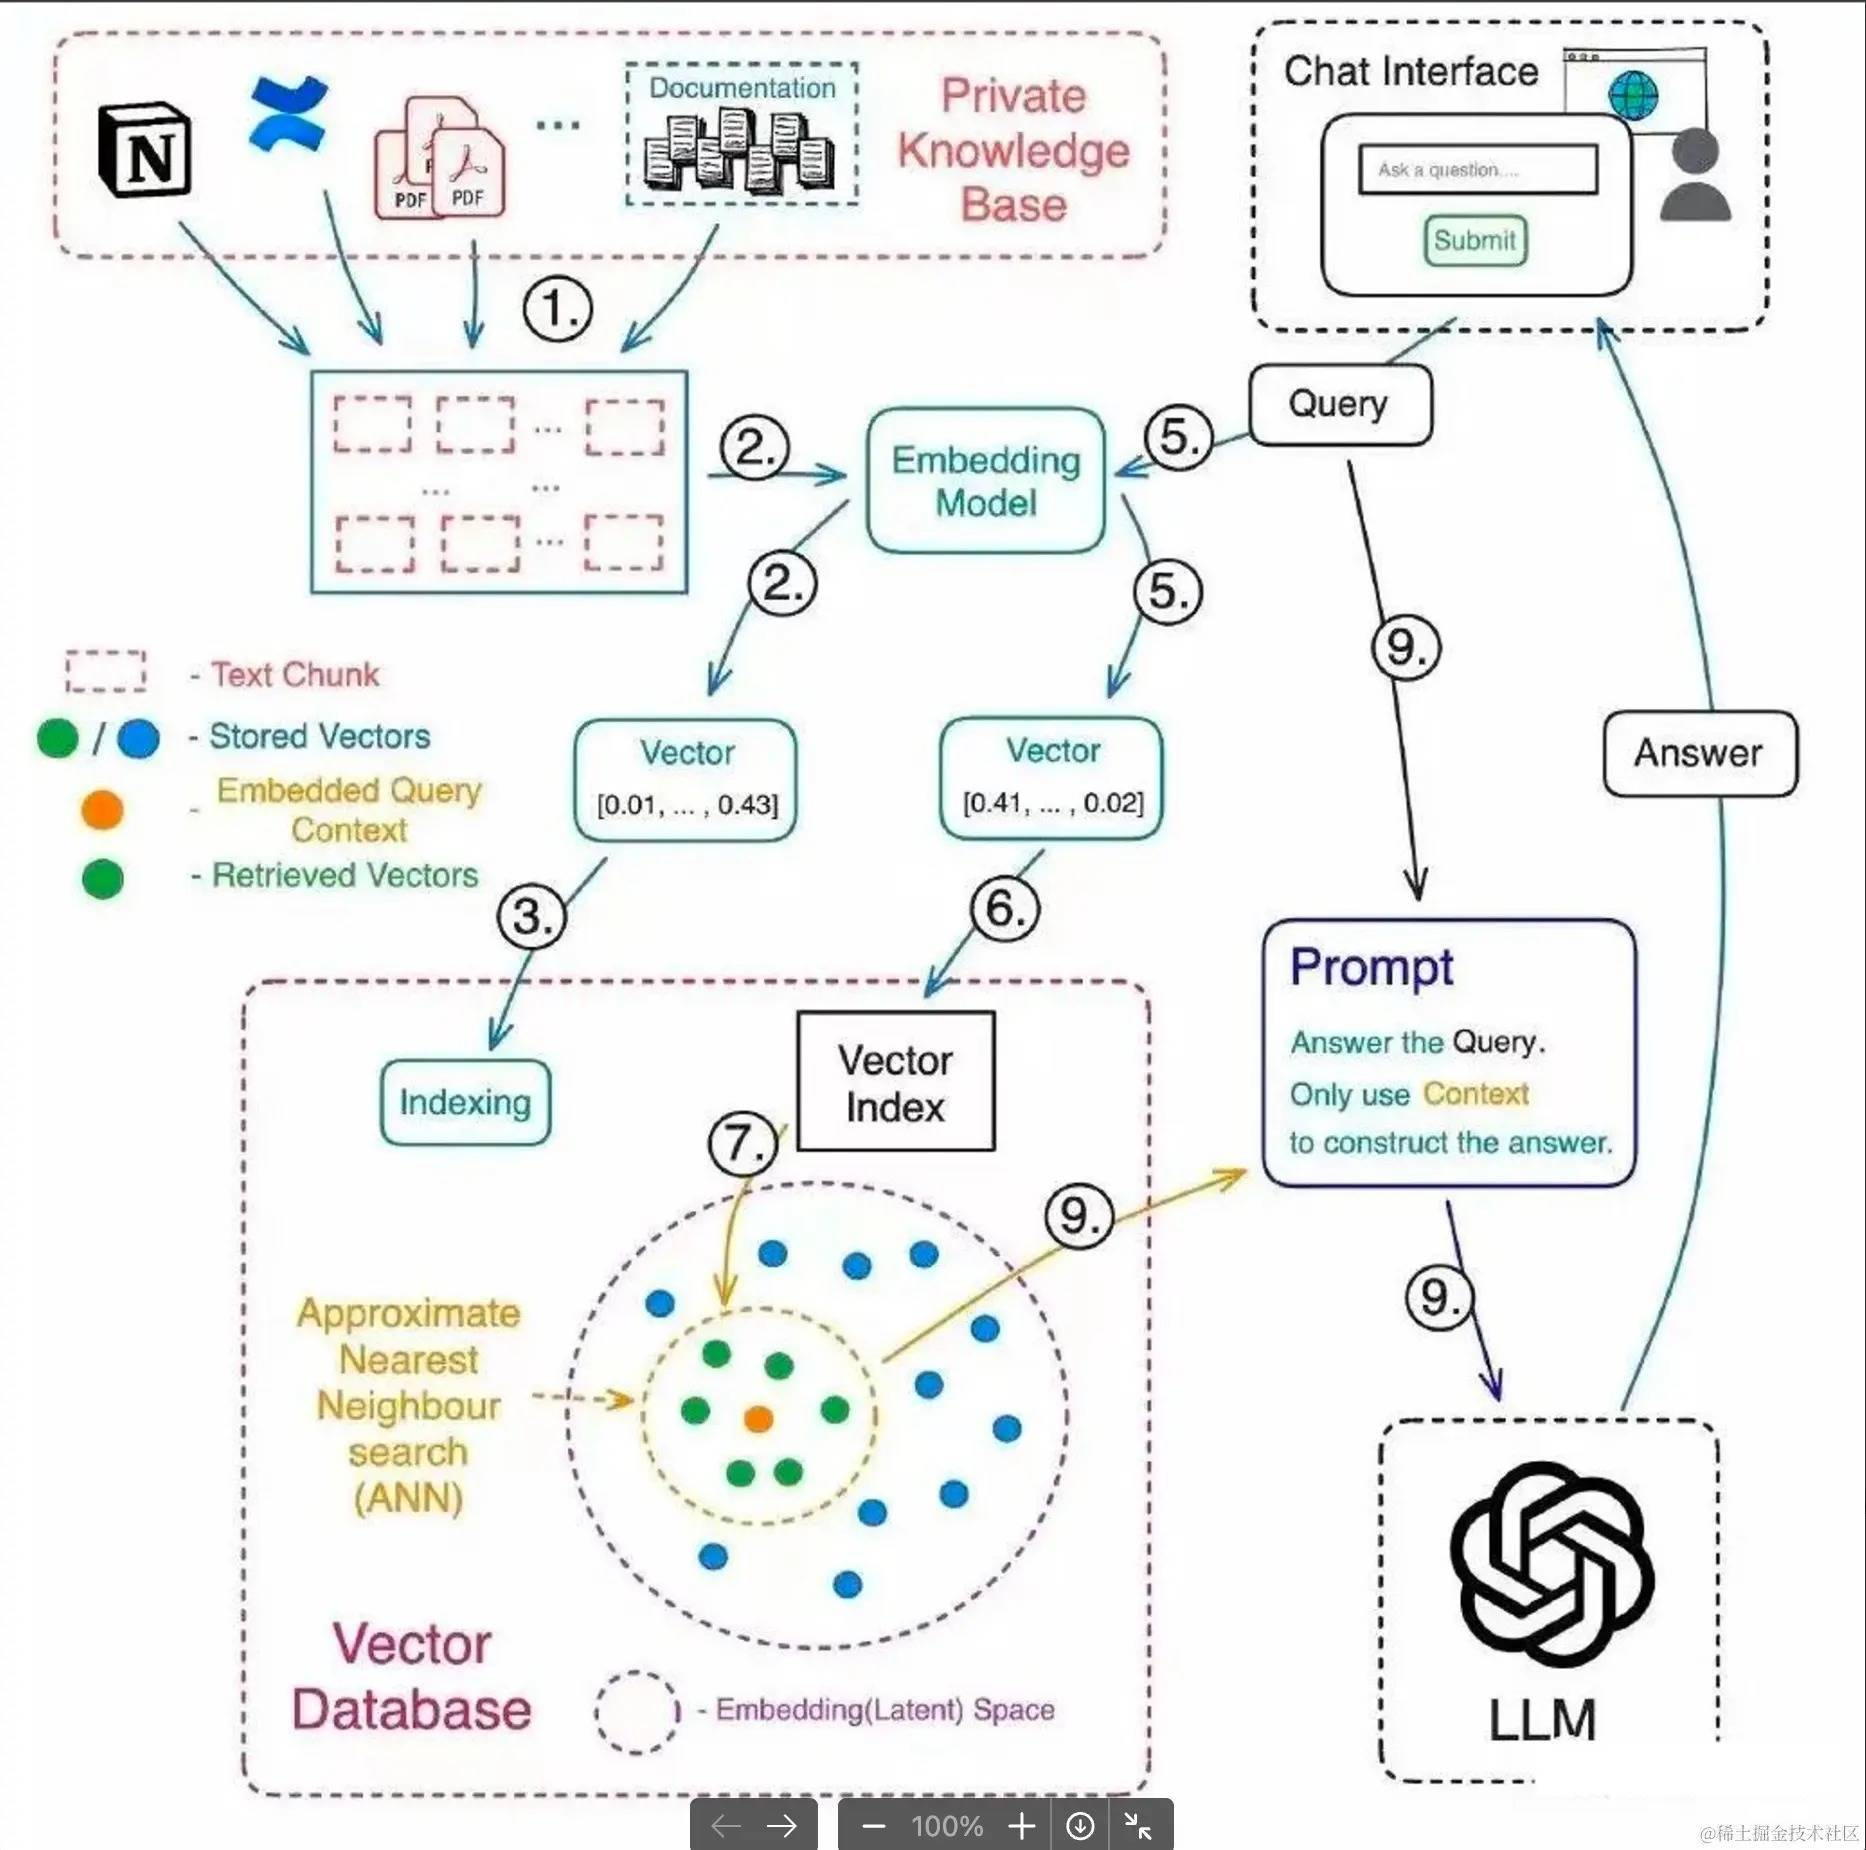
这事儿听着玄,其实早有苗头。你在微信里问AI'上次我提过那个方案怎么改?',它翻遍聊天记录也答不上来——因为那些对话压根没进它的'脑子',只是存在你手机里。RAG干的就是这个活:当个勤快但记不住事的助教,每次都要现找笔记、现读重点、现组织语言。可人不是这么学的。老司机开车不靠导航语音提示,靠肌肉记忆;医生看片不靠翻图谱,靠十年积累的直觉。这些'说不清道不明'的经验,根本没法写成标准文本塞进数据库。
蔡登团队在字节做的实验很说明问题:让模型在真实客服对话中持续接收用户反馈,不光记下'用户点了哪个按钮',还捕捉'用户停顿0.8秒后改口''撤回消息又重发'这类微妙信号,然后用轻量级参数微调实时更新。结果发现,这种'边用边进化'的模型,在3个月后的任务完成率比同期RAG系统高出27%,而且越用越准,不像RAG容易卡在'检索不到匹配项'的死胡同里。这不是替代预训练,而是补上最后一块拼图——让AI真正拥有'工作记忆'和'职业经验'。
说白了,RAG像带着厚厚笔记本开会的实习生,老板一问就低头翻、翻不到就卡壳;而“边用边学”的AI,更像刚转正的年轻骨干——会议中听一句记一句,散会路上就琢磨怎么优化下一句回应,第二天见客户时语气都自然了三分。这不是玄学,是把人类最朴素的学习逻辑还给了机器:试错、反馈、微调、内化。
有人担心“实时更新参数”不安全?其实技术上早有分寸。蔡登团队用的是LoRA(低秩适应)这类轻量微调技术,每次只动模型里不到0.1%的参数,既不会覆盖原始能力,也不需要重训整个大模型。就像给汽车升级车载导航系统,不用拆发动机——工信部《生成式人工智能服务管理暂行办法》第十二条也明确支持“在保障安全前提下开展模型迭代优化”。
更实在的变化发生在一线。杭州一家做跨境客服的创业公司接入这套机制后,用户重复提问率下降了41%,因为AI记住了“李女士上次问过退货物流超时怎么赔”,这次她刚打“退”字,AI就主动弹出带截图的赔付流程。这不是靠检索关键词,是真“记得住人”。类似实践已在美团、拼多多的内部智能助手试点落地,不是实验室里的PPT方案。
当然,这不意味着RAG该被淘汰。它依然是处理法律条文、药品说明书这类强准确性要求场景的可靠搭档。但当面对活生生的人——情绪会变、表达会绕、需求会藏一半说一半时,光靠“查得快”远远不够。真正的智能,得有点“人味儿”:会犹豫、会校准、会从你删掉的半句话里读出潜台词。
教育领域也在悄悄跟进。华东师大附中试点的AI助教,不再只是推送解题步骤,而是观察学生连续三次在“函数图像平移”卡壳后,自动把抽象公式转化成可拖拽的动态图示——这种响应,数据库里没有标准答案,全靠它自己“看出来”的教学节奏。知识没变,但传递知识的方式,终于开始学着“长脑子”了。
双悦网提示:文章来自网络,不代表本站观点。